 审小匠 OpenCPAi
市面上的审计工具几乎都在做同一件事:接口取数。而一线审计师每天真正卡住的地方不在取数,在取数之前——客户给来的那个 Excel 打不开,几十个文件不知道哪个是科目余额表,PDF 里的数字只能一个个手敲。这篇记录我为什么决定自己动手做一个 AI 审计工作台,以及过程中做过的几个技术选择。
审计数据清洗是指把客户给来的各种形态的原始资料——格式不标准的 Excel、扫描件 PDF、命名混乱的一堆文件——转成口径一致、可直接进底稿的结构化数据。它是所有后续计算、勾稽、出表的前置环节,也是目前最依赖手工的环节。
我为什么要做这件事
我做了十年上市公司审计。最切身的感受是,这个行业的年轻人被困在 Excel 里——大量时间不是花在判断上,而是花在把数据从一种形态搬成另一种形态。
有同行这样描述他那段时间的作息:上周五通宵到六点,睡到中午又开始待命,晚上十一点还在发消息,隔天周日一睁眼又无缝上班。
行业信息化落后是公认的事实,但落后的方式有点反常:大家做的多半是 Excel 插件和 VBA,很少有产品愿意在数据清洗上花功夫。我想做的是这件难而正确的事。
为什么没人愿意做数据清洗?
因为它不体面,也不好卖。
接口取数是可控的:对接一款财务软件,拿到结构化的表,演示效果立竿见影。数据清洗是不可控的——客户给来的可能是 xls 伪装成的 xlsx、OLE 对象、导出成 HTML 的伪 Excel、GBK 编码的老文件,甚至是 1997 年格式的工作簿。每多支持一种,就要多调一轮,而且永远有下一种。
我见过行业里做得不错的开发者,他们在软件里直接提示"无法读取该文件,请手工整理",并且在公开的说明里写明这一点。这是理性的商业选择,但它把最耗时的环节留给了审计师。
我认为这正是审计行业效率低的原因之一:最脏最累的那一段,没有人做。
六层架构和一个标准体系
跟 AI 一点点磨,最后落成的是六层架构加一套 XBRL 标准体系。
| 层 | 做什么 | 换账套格式时是否受影响 |
|---|---|---|
| L1 输入 | 把文件读开:各种 Excel 变体、PDF、压缩包 | 是 |
| L2 标准化 | 识别文档类型,统一成标准表结构 | 是 |
| L3 映射 | 科目名称经变体表对到标准科目 | 部分 |
| L4 计算 | 清洗、汇总、勾稽计算 | 否 |
| L5 校验 | 试算平衡、交叉勾稽、异常筛查 | 否 |
| L6 输出 | 底稿、报表、报告 | 否 |
配套的 XBRL 标准体系分五层:元素、标签、计算关系、展示关系、定义关系。这个结构的作用是把"读进来"和"算出去"彻底分开——换一种账套格式只影响 L1 和 L2,不会动到计算和校验。
两个最难的算法:读得开,认得出
第一个是把文件读开。为了应付上面说的那些格式,我和 AI 来回调试留下了一百多份调试文档,最后做成一个叫 SmartExcel 的读取算法。
第二个是认出文件是什么。审计师拿到一堆文件,人能一眼看出哪个是科目余额表、哪个是序时账,算法不能——尤其当文件名词不达意、内容又相似的时候。SmartClassifier 做的就是这件事:区分单 sheet 和多 sheet 工作簿,识别科目余额表、序时账、明细账、财务报表、审计报告、企业所得税申报表、工资表、公司章程、存货清单、固定资产清单等文档类型。
为什么不买现成的 OCR 接口?
两个原因:成本和数据。
这个行业的付费能力摆在那里,如果核心环节依赖按页计费的商业接口,就没法用足够低的成本提供服务。更要紧的是数据——审计资料是客户的财务底账,我不希望它经过第三方接口。
所以选择了在开源算法基础上调试 VLM。我也试过大厂的现成方案,准确率和幻觉问题同样存在。这一段是整个开发过程里最煎熬的:如果算法没有眼睛,AI 审计就不成立。
AI 能替代审计师的职业判断吗?
这个问题要拆成两半才答得准。
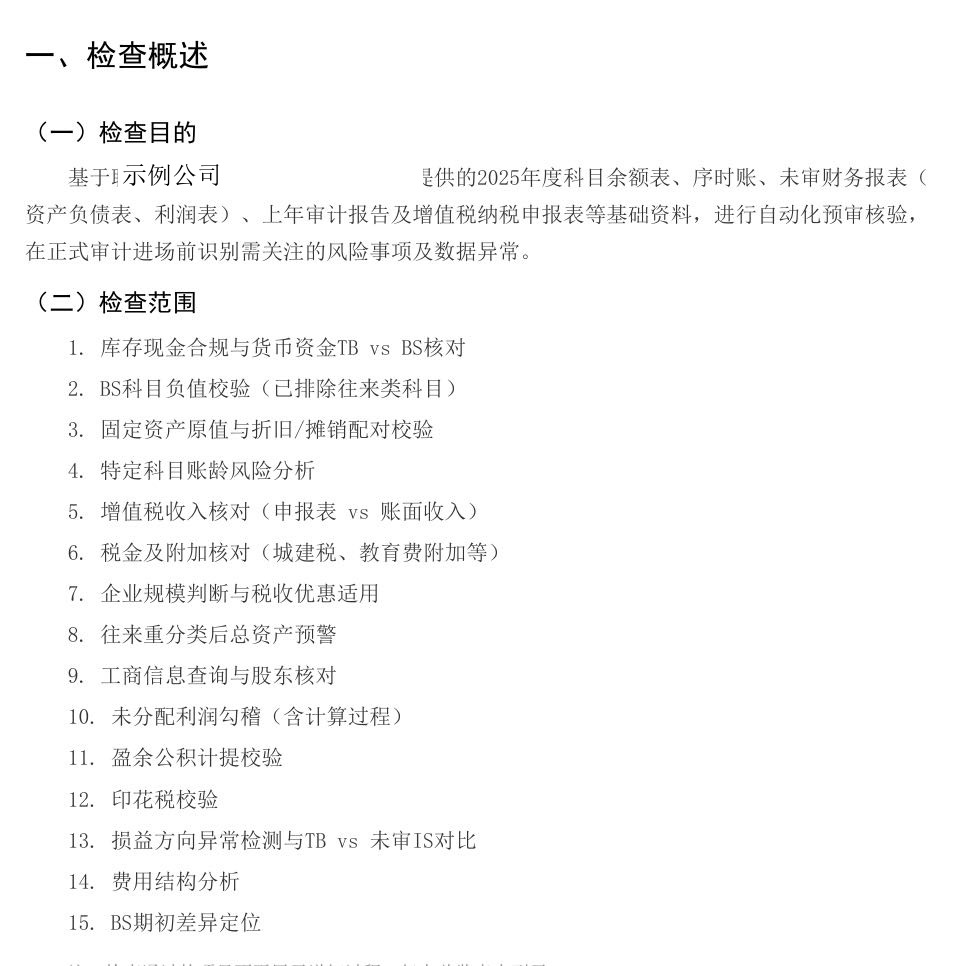
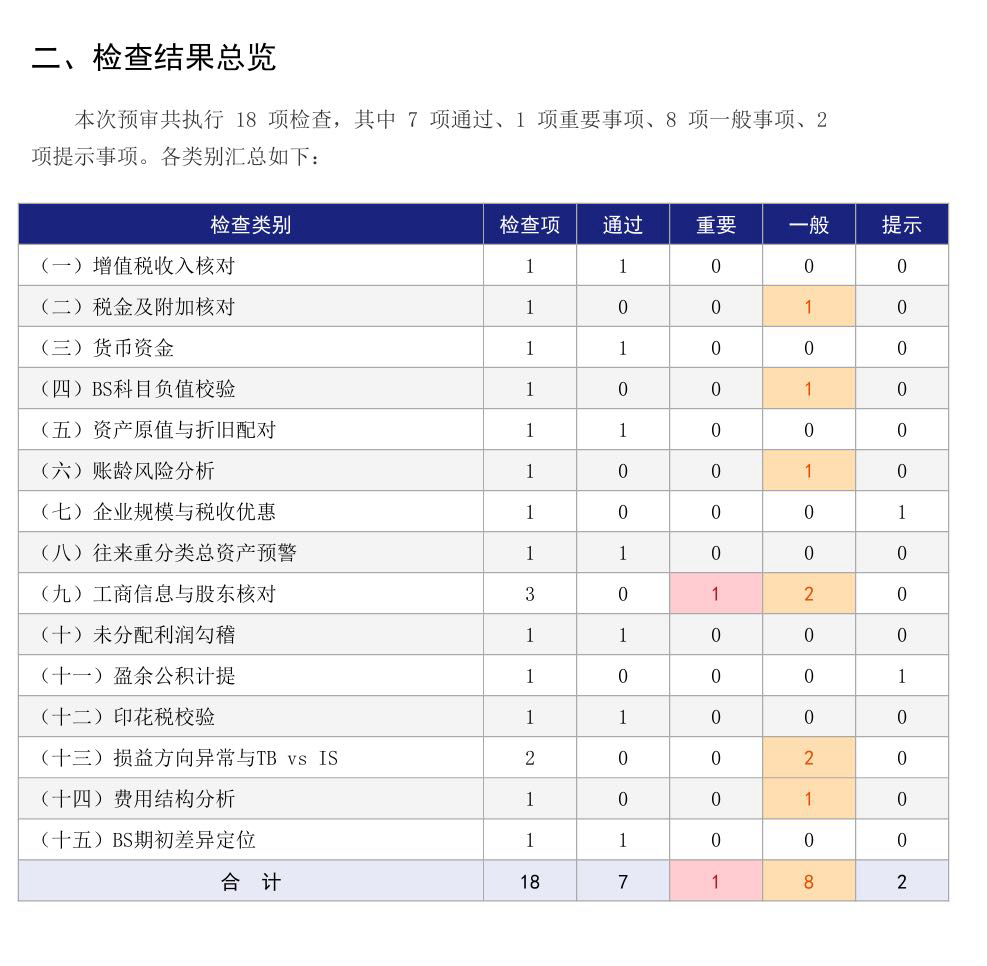
可以规则化的那部分,算法做得比人稳。 比如预审检查里这些:库存现金是否超标、存货是否出现负数余额、短期借款账龄是否超过一年、利润表收入与增值税申报表是否存在差异、费用类损益挂在贷方导致科目余额表发生额与利润表对不上、未分配利润勾稽不平的成因、账面股东名称与工商登记是否一致。这些判断有明确判据,人做会累会漏,算法不会。
真正的职业判断那部分,仍然是人的。 重大错报风险评估、持续经营能力、关联方交易的商业实质、管理层意图——这些依赖对具体情境的理解,算法给不出,也不该给。
算法执行程序不会因为赶进度跳步,也不会因为人情放松,这是它的长处。但底稿由谁复核、鉴证意见由谁出具、谁签字担责,这件事不会因为工具变了而改变。工作台负责把文书工作做完,判断和意见留给审计师。
知识库为什么要自己搭
审计师查问题时要的是有出处的答案,不是像模像样的幻觉。所以做了一个检索型的专业知识库。
对非技术出身的人来说这一步的坑最密:一开始我以为把文档转成 Markdown 塞进数据库、接上大模型就能回答问题。实际上要先想清楚怎么切片、用什么切片策略、选哪种向量数据库、用多少维的向量、哪个模型适配中文专业语料。
写在最后
做第一个 demo 的时候,一位学计算机的学长跟我聊到凌晨两点。他说,如果你真能做出来,这个产品未必有很高的商业价值,但可能会改变这个行业做事的方式。我现在仍然相信这句话。
四大之一已经宣布要投入上百亿美金规模的资金做 AI 审计。我希望这个行业里有更多人来做这件事——把繁琐重复的那部分交给算法,让审计师回到专业判断和客户信任上来。
如果你想看看数据清洗这一段能被做到什么程度,可以从工作台 上传一份客户给的原始账套试试;也可以先读科目余额表借贷不平的 8 种成因与定位方法,那篇写的是清洗环节最常遇到的问题。